
Estatística é a ciência que coleta e organiza os dados e, em seguida, tira conclusões com base nesses dados (Price; Chamberlayne, 2017). Existem basicamente três tipos de estatística: descritiva, multivariada e inferencial. As estatísticas descritivas resumem grandes quantidades de informações de maneira eficiente de fácil compreensão. As estatísticas multivariadas permitem comparações entre fatores, isolando o efeito de um fator ou variável do outros que podem distorcer as conclusões. As estatísticas inferenciais sugerem afirmações sobre uma população com base numa amostra extraída dessa população (Price; Chamberlayne, 2017).
Níveis de medição
Um conceito que se aplica tanto à pesquisa quanto à estatística são os níveis de medição. A medição é um processo de atribuição de números ou rótulos a unidade de análise ou itens em estudo. Os números são atribuídos de forma que se permita que sejam analisados estatisticamente.
Existem quatro tipos de medições: nominal, ordinal, intervalo e razão. A seguir veremos as especificidades de cada uma delas.
Nominal
O nível nominal de medição é o processo de classificação dos dados em categorias. É o nível mais baixo de medição e todas as categorias devem ser exaustivas, abrangendo assim todas as observações que possam existir. Além disso, as categorias devem ser mutuamente excludentes, ou seja, cada observação só pode ser classificada de uma forma. As medidas nominais apenas apresentam nomes ou rótulos para distinguir as observações. Exemplos de medidas nominais incluem: sexo (masculino, feminino), estado civil (casado, solteiro, viúvo, divorciado), raça, escolaridade, profissão etc.
Mesmo que atribuamos um número para representar um rótulo, “1” para “masculino” e “2” para “feminino”, o dado continua sendo nominal, ou seja, não há maneira lógica de se ordenar os dados ou mesmo realizar cálculos com eles.
Ordinal
O nível ordinal de medição consiste nas categorias que são também exaustivos e mutuamente excludentes, mas que apresentam um grau de diferença entre as categorias de uma escala. Este grau de diferença indica ordem ou classificação entre categorias. As categorias são ordenadas de alguma forma, mas a “distância” entre as ordenações não tem significado. Exemplos: nível de medo do crime, gravidade do crime, escala likert (concordo totalmente, concordo parcialmente, neutro, discordo parcialmente, discordo totalmente).
Intervalo
O nível de medição de intervalo consiste também na categorização exclusiva, excludente e passível de ser ordenada. Além disso, o nível de intervalo pressupõe que todos os itens de uma escala possuem unidades ou intervalos iguais entre eles. A “distância” entre as categorias possuem significado. Exemplos: temperatura, QI.
Razão
O nível de medicação de razão contém ponto zero verdadeiro, o que significa a ausência total do conceito sob medida. Exemplos: peso, renda, tempo, idade.
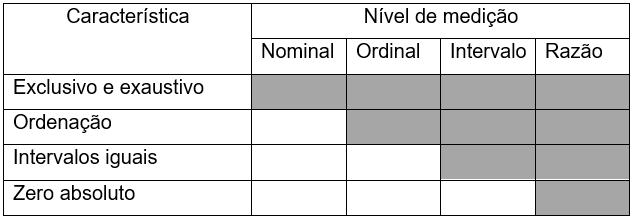
As implicações sobre os níveis de medição são:
- a razão é o nível de medição mais elevado porque contém todas as características dos demais níveis;
- os pesquisadores e analistas devem procurar os níveis mais elevados de medição possíveis, considerando o tempo, esforço e custos do estudo. Níveis superiores de medição podem ser convertidos em níveis inferiores, mas o contrário não é possível;
- a técnica estatística a ser aplicada determinará o nível de medição necessário. Técnicas específicas exigem níveis mínimos de medição.
De maneira ideal, conceitos podem ser medidos em diferentes níveis de medição, dependendo de como os dados são coletados. Por exemplo, o conceito de idade pode ser medido utilizando-se os conjuntos de respostas para cada nível de medição:
- nominal: “jovem”, “velho”
- ordinal: “0-6”. “7-13”, “14-20”, “30+”
- intervalo: “1-20”, “21-40”, “41-60”, “61-80”
- razão: 0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, etc.
Distribuições
O entendimento acerca da distribuição dos conjuntos de dados é fundamental para o analista. Alguns conjuntos de dados podem ser muito grandes e complexos. Os dados devem ser descritos de uma maneira que sejam facilmente compreendidos. Um dos primeiros passos na análise de dados é construir uma distribuição de frequência, que liste o número ou frequência de pontuações ou rótulos para cada caso individual. A distribuição de frequência permite uma descrição básica do conjunto de dados e uma representação gráfica. A representação gráfica é fundamental para permitir uma visualização e análise de grandes volumes de dados.
Inicialmente parte-se dos dados brutos, que são aqueles que não foram numericamente organizados, ou seja, estão na forma com que foram coletados
Exemplo:
Dado um conjunto de 23 infratores com o respectivo número de vezes que cada um foi preso. Suponhamos que queiramos saber quantos indivíduos já foram presos mais de três vezes.
1, 3, 7, 2, 5, 2, 4, 2, 1, 5, 6, 2, 3, 1, 4, 2, 3, 4, 3, 3, 5, 6, 12.
Para se construir a tabela contendo o intervalo de frequência primeiramente se cria a coluna X (que representa o número de prisões de cada indivíduo) e posteriormente ordena-se os dados, criando-se o rol (organização dos dados brutos em ordem de grandeza crescente ou decrescente):
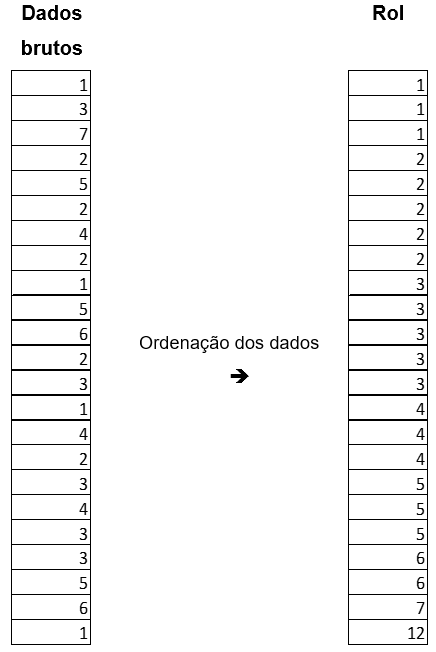
Na sequência remove-se as duplicatas de valores e realiza-se a contagem de cada um dos rótulos de x.
A distribuição de frequência para os dados de prisões consta da Tabela a seguir:
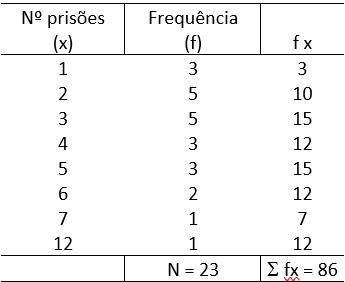
Conforme os dados organizados na tabela de frequência, a coluna x indica que o conjunto dos 23 infratores apresenta entre 1 e 12 prisões. Verifica-se ainda que 10 infratores tiveram mais de três prisões e que ao todo houve 86 prisões.
Determinação do número de classes
Classes são intervalos de variação da variável. As classes são representadas simbolicamente por i, sendo i = 1, 2, 3, . . ., k (onde k é o número total de classes da distribuição).
É importante que a distribuição conte com um número adequado de classes. Se o número de classes for excessivamente pequeno acarretará perda de detalhe e pouca informação se poderá extrair da tabela. Por outro lado, se for utilizado um número excessivo de classes, haverá classes com frequências nulas ou muito pequenas, não atingindo o objetivo de classificação.
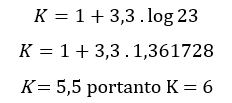
Para se saber o número de classes é possível utilizar a Regra de Sturges, que fornece o número de classes em função do número de observações:
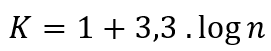
Sendo:
- K = número de classes
- n = número de observações.
Para o exemplo acima, em que n = 23 teremos:
Para facilitar o cálculo do número de classes pela regra de Sturges, pode-se utilizar a tabela abaixo:
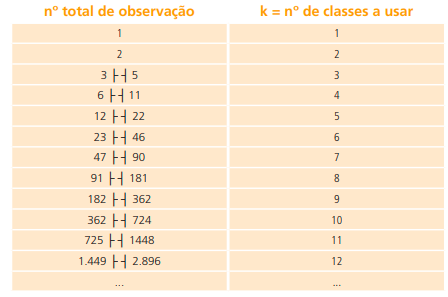
Observação:
├ ┤ Inclui tanto o valor da direita quanto o da esquerda
– Não inclui nem o valor da direita, nem o da esquerda
┤ Inclui o valor da direita, mas não o da esquerda
├ Inclui o valor da esquerda, mas não o da direita
A amplitude (H) é uma estatística resumida dos dados que fornece informações limitadas, mas que permite condensar uma distribuição de frequência. A amplitude total é a pontuação mais alta (Limite Superior – Ls) menos a pontuação mais baixa (Limite Inferior – Li).
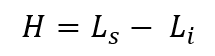
No exemplo acima, o intervalo é H = 21-1 = 11.
Para se condensar a distribuição, o intervalo é usado para criar agrupamentos de informações em intervalos de classes (categorias). A amplitude do intervalo (Ai) é descrita como:
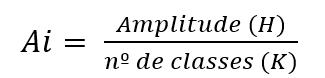
No exemplo, temos que agrupar em 6 intervalos. Assim teremos:
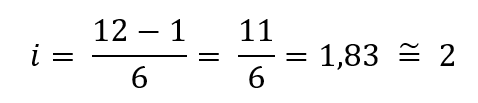
Ou seja, cada intervalo terá dois casos.
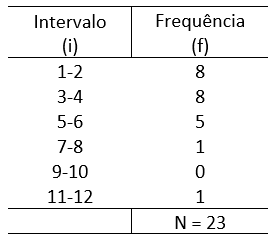
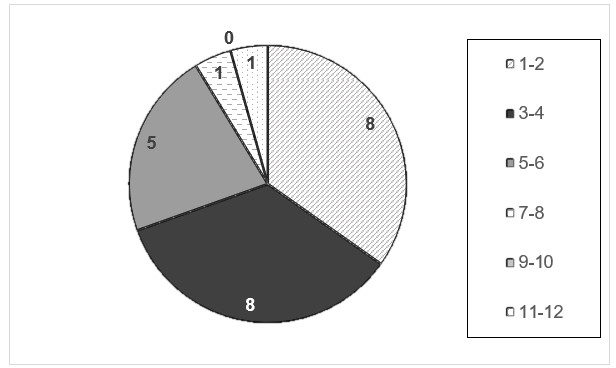
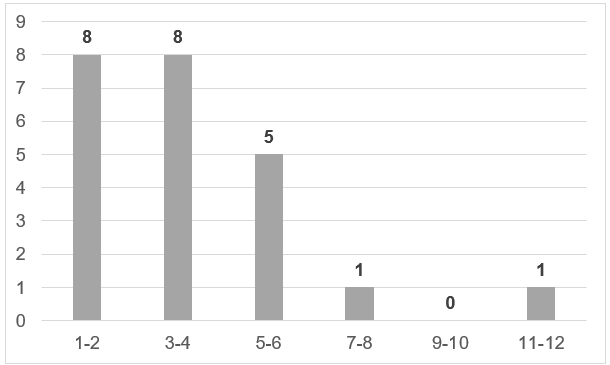
Dados em distribuição de frequência facilitam a representação gráfica e consequentemente sua interpretação. O objetivo das representações gráficas em Tabelas ou Gráficos é a sua rápida compreensão.
Tipos de Frequência
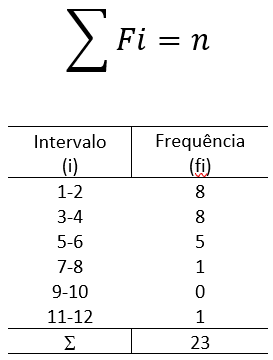
Frequências simples ou absolutas (fi)
É o número de repetições de um valor individual ou de uma classe de valores da variável. A soma das frequências simples é igual ao número total dos dados da distribuição.
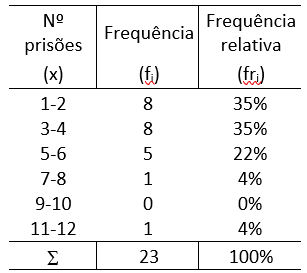
Frequência relativa Fri
São os valores das razões (divisões) entre as frequências absolutas de cada classe e a frequência total da distribuição. A soma das frequências relativas é igual a 1 ou100%
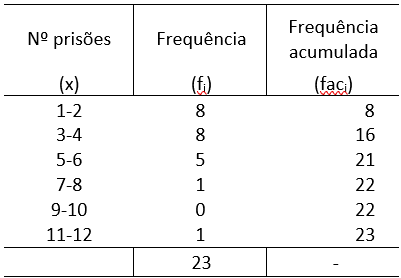
Frequência simples acumulada (faci)
É o total das frequências de todos os valores inferiores ao limite superior do intervalo de uma determinada classe.
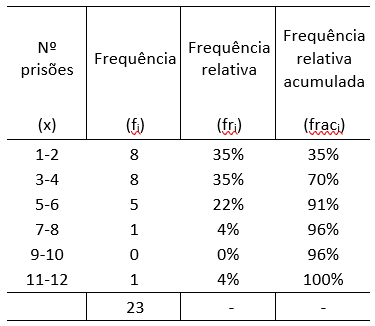
Frequência relativa acumulada (fraci)
É a frequência acumulada da classe, dividida pela frequência total da distribuição.
Medidas de posição
Normalmente quando dados estatísticos são analisados, procuramos obter um valor para representar o conjunto de dados. Este valor deve sintetizar, da melhor maneira possível, o comportamento do conjunto do qual ele é originário. Nem sempre os dados estudados têm um bom comportamento, isto pode fazer com que um único valor possa representá-lo ou não perante o grupo.
As medidas de posição mais importantes são as medidas de tendência central e as medidas de dispersão.
Medidas de tendência central
As medidas de tendência central, que recebem tal denominação pelo fato de os dados observados tenderem, em geral, a se agrupar em torno dos valores centrais. Dentre as medidas de tendência central, destacam-se as seguintes: Médias, Moda e Mediana, cada qual com um significado diferenciado, porém tendo como objetivo representar um conjunto de dados.
Média aritmética simples
Para se obter a média aritmética simples de um conjunto de dados, devemos dividir a soma dos valores de todos os dados do conjunto pela quantidade deles.
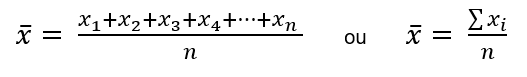
Onde:
- xi = são os valores que a variável x assume
- n = o número de valores
- X = é a média aritmética da amostra
Média aritmética ponderada
Média ponderada é uma média aritmética na qual será atribuído um peso a cada valor da série.
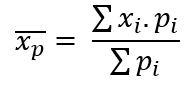
Moda (Mo)
Define-se a moda como o valor que ocorre com maior frequência em conjunto de dados.
Exemplos:
Dados os seguintes conjuntos e suas modas:
X = (4, 5, 5, 6, 6, 6, 7, 7, 8, 8) → Mo = 6 (0 valor mais frequente)
Esse conjunto é unimodal, pois apresenta apenas uma moda.
Y = (1, 2, 2, 2, 3, 4, 4, 4, 5, 5, 6) → Mo = 2 e Mo = 4 (valores mais frequentes)
Esse conjunto é bimodal, pois apresenta duas modas.
Z = (1, 2, 2, 2, 3, 3, 3, 4, 4, 4, 5) →Mo = 2, Mo = 3 e Mo = 4 (valores mais frequentes) Esse conjunto é plurimodal, pois apresenta mais de duas modas.
A moda é utilizada quando desejamos obter uma medida rápida e aproximada de posição ou quando a medida de posição deva ser o valor mais típico da distribuição.
Um exemplo de aplicação para a Análise Criminal Administrativa:
Considerando a necessidade de se dimensionar a quantidade de viaturas disponíveis para emprego nos turnos operacionais é importante verificar qual o número de viaturas que mais é empregado por dia durante um mês de trabalho.
Considerando que pode haver uma grande variação do número de viaturas por faixa horária, não faz sentido verificar a média, mas sim qual o número de viaturas que mais se repete para se fazer uma previsão de dotação logística.
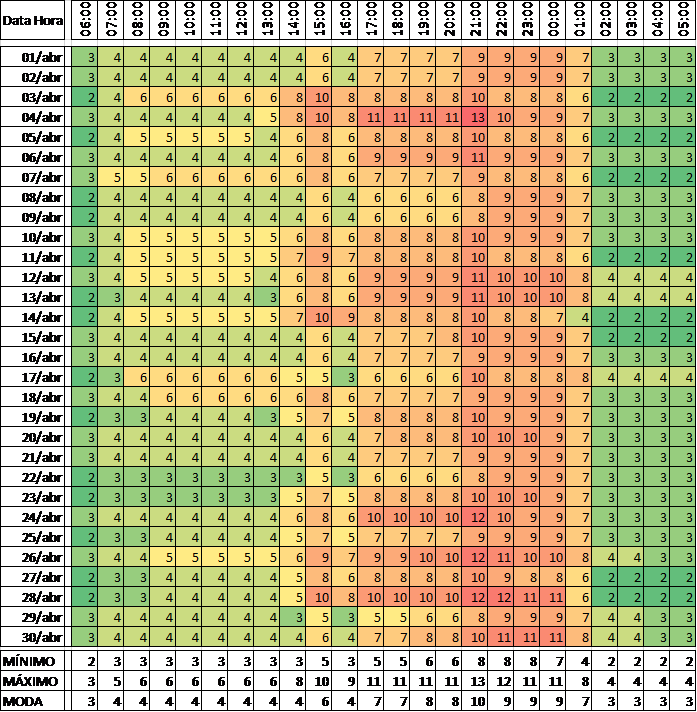
Neste exemplo hipotético, caso se deseje planejar o número de viaturas pelo número de viaturas que mais vezes foi empregado será utilizada a moda.
A moda é a única medida de tendência central que também pode ser aplicada às variáveis nominais, como: mês de nascimento, religião, estado civil, etc. Outro aspecto é que um conjunto de dados pode ter mais de uma moda. Pode-se dizer que o gráfico de uma distribuição bimodal sugere as corcovas de um camelo, pois ela tem dois pontos de frequência máxima. A modalidade unimodal, que costuma ser mais comum, tem, evidentemente, apenas um ponto de frequência máxima.
Mediana (Md)
A mediana tem caráter mais geométrico, de simetria, em comparação as demais medidas. É uma medida de posição (Medida de Tendência Central) cujo valor divide um conjunto de dados em duas partes iguais. Portanto, a mediana se localiza no centro de um conjunto de números ordenados segundo uma ordem de grandeza. Ou seja, a Mediana indica qual é o valor que está exatamente no meio de um conjunto de dados, quando eles estão ordenados.
Para se obter o elemento mediano de uma série deveremos seguir os seguintes procedimentos:
a. Se N (número de elementos do conjunto) for ímpar a mediana é o termo de ordem P dado pela razão:
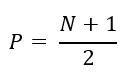
b. Se N (número de elementos do conjunto) for par, então a amostra terá dois valores centrais e a mediana será a média aritmética entres. E como encontrar os valores centrais?
P1: (Número de elementos da amostra) dividido por 2;
P2: [(Número de elementos da amostra) dividido por 2 ] + 1
A vantagem da Mediana sobre a Média é que a Mediana pode nos fornecer um valor típico do conjunto de dados porque ela não é afetada por valores extremos.
Exemplo de aplicação:
Número de ímpar de elementos:
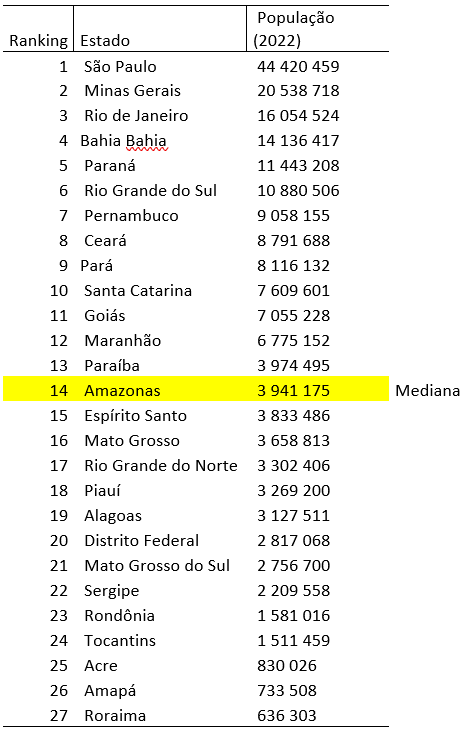
Considerando-se que são 27 Unidades Federativas, a mediana estará localizada na posição (27+1) ¸ 2 = 14.
Interpretação: A mediana indica neste caso que metade dos Estados do Brasil possui população menor ou igual a 3.941.175 e a outra metade possui população maior ou igual a 3.941.175.
| A aplicação do conceito de mediana pode ser expandida para aquelas situações em que o conjunto de dados precisa ser dividido em mais de dois subgrupos. Um caso importante é aquele em que dividimos o conjunto em quatros subgrupos. Para tanto, além da mediana, é importante calcular mais dois valores: um que separa 25% dos valores abaixo dele, e outro que indica o valor em que 75% estão abaixo de si. Ou seja, o primeiro quartil (Q1) e o terceiro quartil (Q3). O segundo quartil é, evidentemente, a mediana: Q2=Md. |
Assim, os quartis Q1 e Q3, juntamente com a mediana, oferecem informações importantes sobre o centro, a dispersão e a distribuição. A distância entre os quartis Q1 e Q3 é uma medida simples de dispersão que dá o intervalo abrangido pela metade central dos dados. Essa distância é denominada de intervalo interquartil: IQ= Q3 – Q1.
O gráfico boxplot é um gráfico que indica cinco importantes valores: o valor mínimo, o primeiro quartil, a mediana, o terceiro quartil e o valor máximo. Alguns gráficos boxplot também indicam os outliers, ou seja, aqueles valores com os quais devemos tomar cuidado, pois parecem fugir do padrão dos demais valores.
Utilizando-se como exemplo o mesmo conjunto de dados acima:
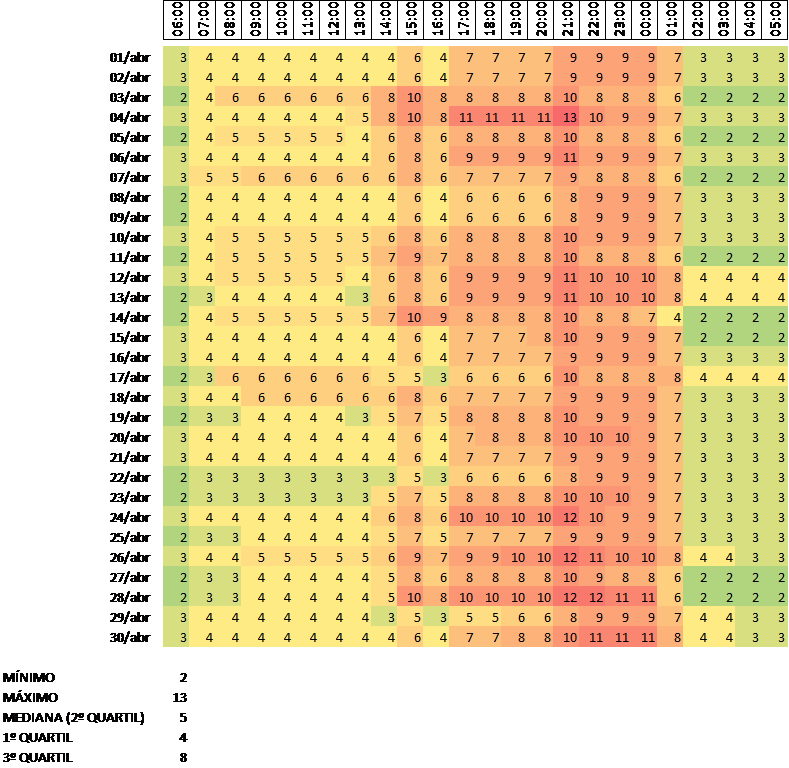
Podemos construir o Gráfico Boxplot a fim de melhor representar o conjunto de dados:
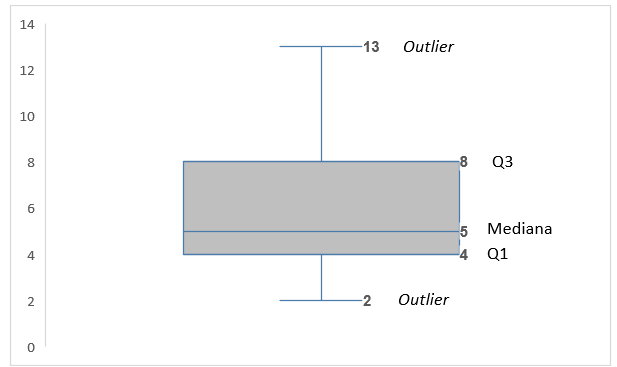
Se, em um conjunto de dados, um valor for maior que o terceiro quartil adicionado ao intervalo interquartil, ele não será considerado um valor máximo, e sim um outlier. Da mesma forma, um valor que for menor que o primeiro quartil adicionado ao intervalo interquartil não será considerado um valor mínimo, e sim um outlier.
| Vimos aqui três medidas estatísticas que são chamadas de tendência central: a média, a mediana e a moda. Essas medidas também são chamadas de posição, pois indicam uma posição central. Entretanto, nem todas essas medidas são adequadas para indicar o centro. |
Medidas de dispersão
As medidas de dispersão ou variabilidade são utilizadas para encontrar o grau de variabilidade ou dispersão dos valores observados em torno da média aritmética. Servem para medir a representatividade da média e destacam o nível de homogeneidade ou heterogeneidade dentro de cada grupo estatístico analisado.
Medida de dispersão absoluta: Amplitude Total (AT)
A amplitude total é a diferença entre o maior e o menor valor observado.
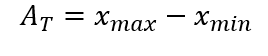
Variância
A variância é uma medida de variabilidade dos dados que representa a média aritmética dos quadrados dos desvios. Já o desvio padrão é mais utilizado pois é a raiz quadrada da variância e, portanto, expressa mais adequadamente o valor em relação à média.
Variância:
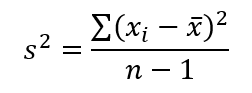
Desvio padrão:
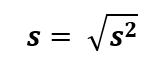
O desvio padrão mede a distância média que cada item à média dos dados em uma distribuição. Assim, sugere a variação em relação à média. O desvio padrão é significativo porque fornece informações sobre como os itens de uma distribuição estão em relação a outros e ainda permitem comparar distribuições entre si.
Considerando que as médias podem ser enganosas devido sofrerem discrepâncias de valores extremos, é conveniente que se avalie em conjunto com o desvio padrão.
Exemplo:
Calculando-se a média e desvio padrão para um conjunto de 10 dados:
1, 5, 9, 13, 17, 18, 21, 22, 25, 29:
Primeiramente calculamos a média dos dados:
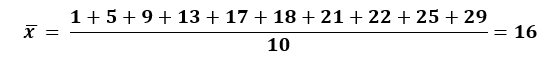
Para se calcular o desvio de cada valor fazemos a operação:

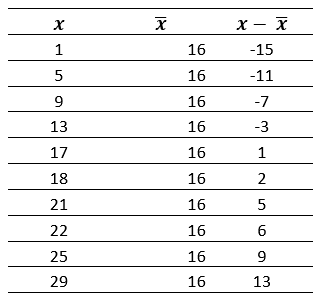
Nós então calculamos o quadrado de cada desvio:

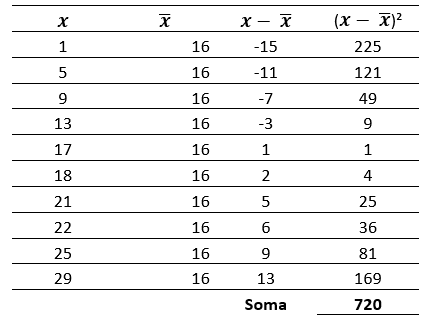
A partir da soma dos desvios, dividimos pelo número de dados – 1, no caso, 10-1=9, e temos a variância s²:
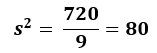
O desvio padrão será a raiz quadrada da variância. Portanto:
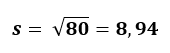
Simetria e assimetrias em dispersão
Há numa distribuição unimodal três diferentes padrões: distribuição normal, distribuição assimétrica positiva e distribuição assimétrica negativa.
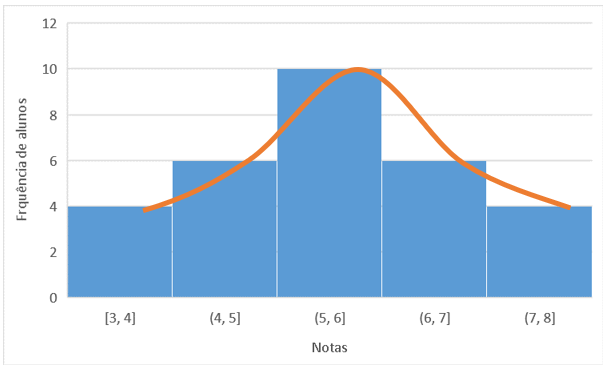
Por exemplo, numa distribuição de notas de 30 alunos (5, 3, 7, 4, 4, 6, 3, 7, 6, 6, 5, 3, 6, 6, 6, 3, 7, 3, 5, 4, 4, 6, 4, 8, 4, 7, 5, 6, 5) num histograma verifica-se que há uma distribuição simétrica.
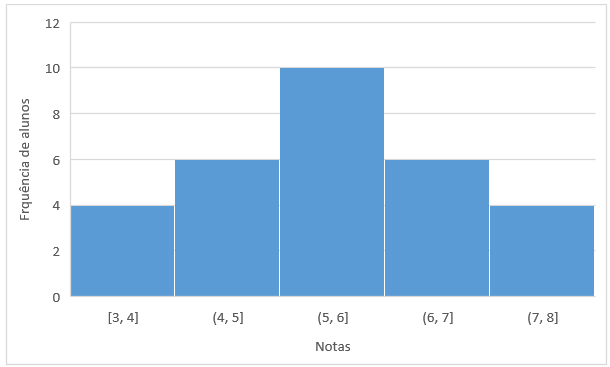
| Um histograma é uma espécie de gráfico de barras que demonstra uma distribuição de frequências. No histograma, a base de cada uma das barras representa uma classe e a altura representa a quantidade ou frequência absoluta com que o valor de cada classe ocorre. |
No histograma acima pode-se traçar uma curva com a distribuição dos dados:
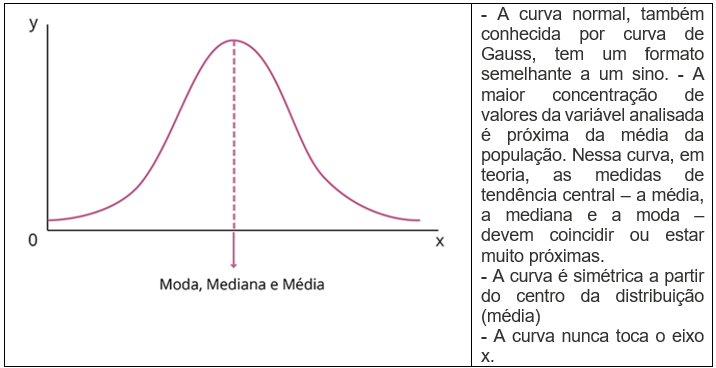
O gráfico da curva normal pode apresentar valores mais ou menos concentrados em torno da média. Isso pode ser observado na figura a seguir, que mostra três gráficos, construídos com a mesma escala.
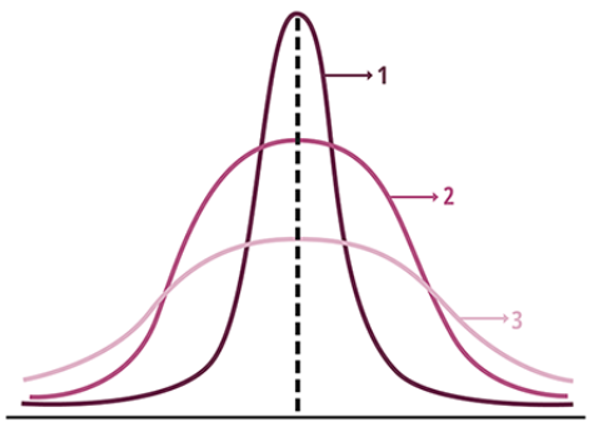
A mediana, a moda e a média dessas três curvas são iguais, mas podemos observar que os dados da curva 1 estão mais agrupados, menos dispersos em torno desses valores, ao contrário da curva 3, que apresenta maior dispersão, ou seja, menor concentração em torno da média. Já a curva 2 apresenta maior dispersão que a curva 1 e menor dispersão que a curva 3.
Assim, podemos concluir que a curva 1 é a que tem menor desvio padrão, e a curva 3 é a que apresenta o maior desvio padrão.
Há alguns fatores a respeito da curva normal sobre os quais é importante estar ciente:
- a área compreendida entre a curva normal e o eixo horizontal pode ser associada à totalidade de elementos da população analisada, uma vez que determinada parte dessa área pode ser associada a uma parte da população, ou seja, à quantidade de elementos da população que possuem determinada característica;
- Em uma curva normal, seja ela representativa de uma população com grande desvio padrão ou de uma população com desvio padrão menor (uma curva mais “achatada” ou mais “alongada para cima”), haverá sempre, entre a média da população e um desvio padrão acima, o mesmo porcentual da curva, igual, aproximadamente, a 34%. Da mesma forma, pela simetria da curva normal, entre um desvio padrão abaixo e a média, estará 34% da população.
Assim, podemos concluir que, entre um desvio padrão abaixo da média e um acima da média, estão 68% de todas as observações. Da mesma forma, nos demais intervalos de desvios acima ou abaixo da média, podemos esperar porcentuais constantes, conforme representado na figura seguinte.
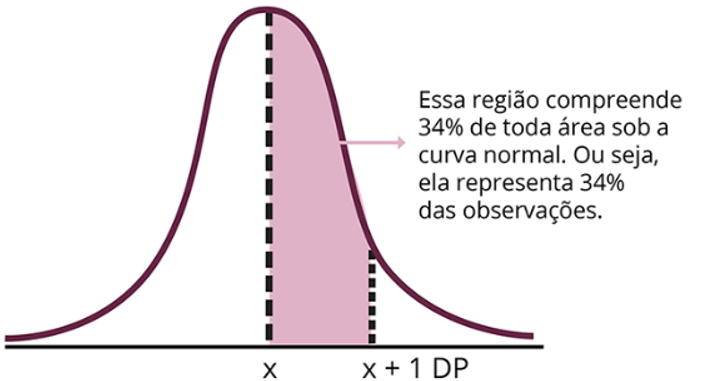
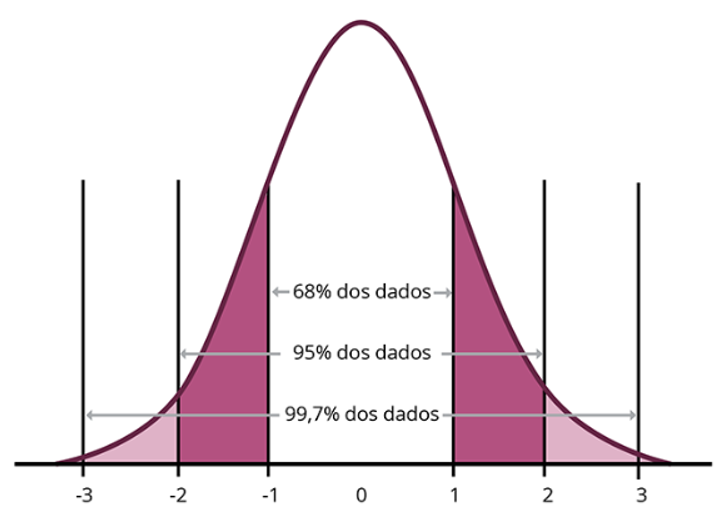
Assim, como as pontuações estão distribuídas uniformemente em torno da média, a área sob a curva normal que se encontra dentro de um desvio padrão da média possui 68% dos casos. 95% dos casos estão entre a média e 2 desvios padrão. E, 99,7% dos casos estão dentro de 3 desvios padrão ao redor da média.
Assimetrias
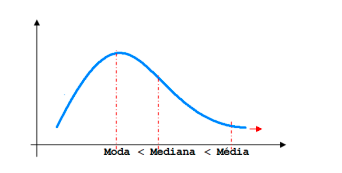
Uma distribuição unimodal com assimetria positiva consiste em pontuações poderadas para a esquerda, ou seja, a protuberância da curva está localizada para a esquerda e a cauda da distribuição se move para a direita. Assim, a cauda da distribuição é mais longa à direita porque há um número maior de pontuações que possuem valores mais elevados do que a maior parte da distribuição. Nesse caso, a moda seria menor valor que a mediana, que por sua vez seria menor que a média.
Figura – Assimetria positiva
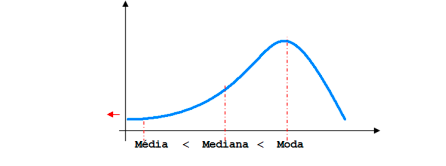
Quando a moda é maior do que a mediana, e a mediana é maior do que a média tem-se uma distribuição assimétrica à esquerda, ou de assimetria negativa, de acordo com a figura seguinte.
Figura – Assimetria negativa
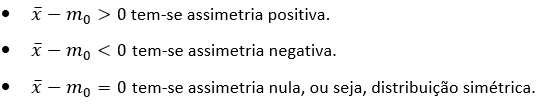
É possível determinar a assimetria da distribuição por meio da fórmula conhecida como primeiro coeficiente de assimetria de Pearson:
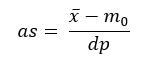
Como o desvio padrão é sempre positivo, o que irá determinar se a assimetria é positiva, negativa ou nula é resultado do numerador da fórmula. Isto significa que:
Considerações Finais
A análise quantitativa por meio da estatística descritiva fornece um conjunto de ferramentas fundamentais para a coleta, organização e interpretação de dados. Ao distinguir entre os diferentes níveis de medição – nominal, ordinal, intervalo e razão – evidencia-se a importância de selecionar o método adequado para cada tipo de dado, assegurando que as análises sejam precisas e significativas.
A construção de distribuições de frequência e a aplicação de medidas de tendência central, como média, mediana e moda, permitem sintetizar e representar grandes volumes de dados de maneira compreensível. A compreensão das medidas de dispersão, como a variância e o desvio padrão, complementa essa análise ao fornecer informações sobre a variabilidade e homogeneidade dos dados.
Além disso, o entendimento sobre a simetria e assimetria das distribuições é essencial para identificar padrões e tendências dentro dos dados. A curva normal, com suas propriedades e percentuais constantes, destaca-se como uma referência importante na estatística.
Em síntese, a estatística descritiva não apenas facilita a organização e visualização dos dados, mas também fornece as bases para análises mais complexas e inferenciais. A aplicação adequada dessas técnicas permite que pesquisadores e analistas obtenham conclusões precisas e fundamentadas, contribuindo para a tomada de decisões informadas em diversas áreas do conhecimento.
